Tại sao phải làm đơn giản trong khi có thể làm phức tạp
Tại sao phải làm đơn giản khi có thể làm phức tạp
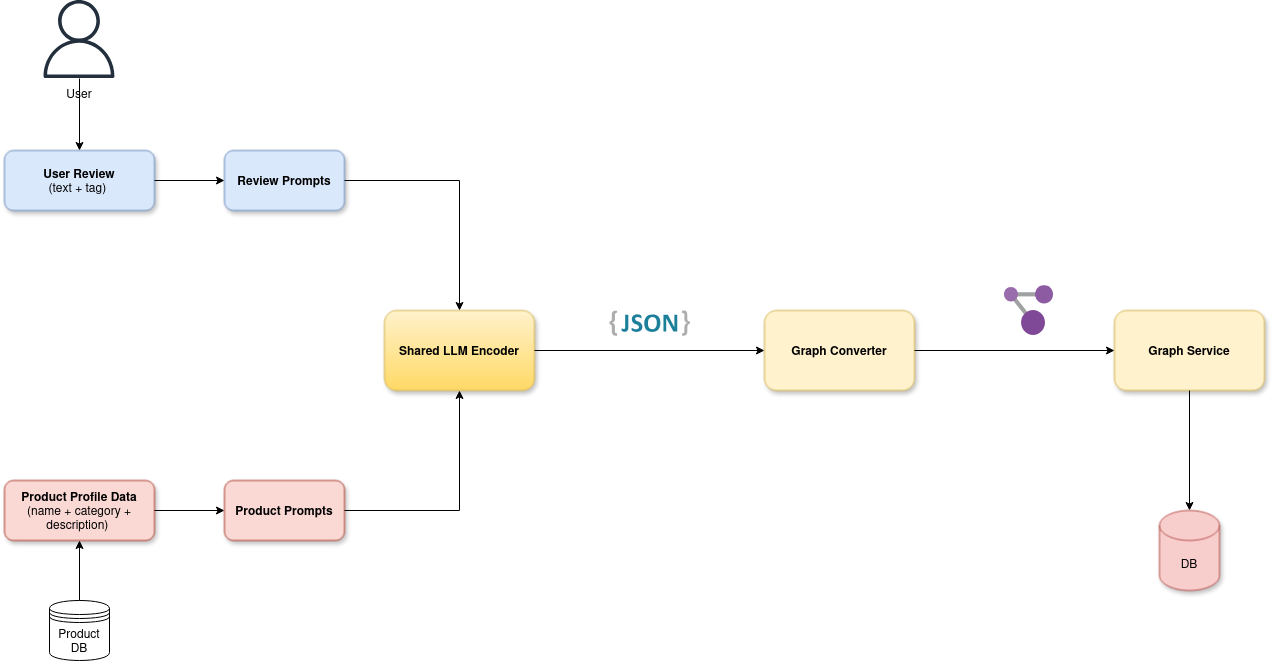
Trong dự án team mình làm trên ứng dụng MoMo, có phần review các sản phẩm như phim, quán ăn, xe khách, các dịch vụ tài chính, bảo hiểm. Ngoài các tính năng cơ bản để user viết, upload media, tạo review rồi tương tác với nhau, team muốn làm thêm một tính năng gì đó trông ngầu xíu, tính năng AI summary — tự động tóm tắt các review của một sản phẩm được team lựa chọn. Bài này phân tích cách team mình sử dụng các thuật toán duyệt đồ thị cơ bản lưu trữ và build response.
Hướng tiếp cận đơn giản
Cách làm đơn giản nhất thì ai cũng nghĩ ra: câu lệnh prompt có sẵn, mỗi ngày có review mới thì gom lại rồi gọi ChatGPT, backend nhận kết quả lưu vào database cho app hiển thị là xong.
   [Review mới mỗi ngày]
            |
            v
   [Cron gom review theo product]
            |
            v
   [Gọi LLM + prompt cố định]
            |
            v
   [Backend lưu nguyên cục JSON vào DB]
            |
            v
   [App đọc cục JSON ra hiển thị]
Một cron job, một collection hoặc 1 Redis hash map, lưu nguyên plain-JSON object theo productId. App call api, BE query theo productId ra JSON object là ổn.
Nhưng việc gì phải làm đơn giản khi có thể làm nó phức tạp
Yêu cầu thực tế thì chi tiết hơn thế. Không chỉ một đoạn tóm tắt chung, mà bóc tách từng khía cạnh (kịch bản, diễn xuất, hình ảnh...), mỗi khía cạnh chia theo cảm xúc tích cực / tiêu cực / trung tính, rồi mỗi cảm xúc kèm vài review tiêu biểu làm bằng chứng.
Và rồi prompt trả về một cấu trúc tương đối phức tạp:
{
  "response_info": {
    "error_message": "Success",
    "error_code": 200,
    "event_tracking": "get-summary-review"
  },
  "body": {
    "productId": "562949953434832",
    "summaryReview": "Review phim Nhà gia tiên của Huỳnh Lập (lưu ý đây là trải nghiệm cá nhân mình, mình sẽ không spoil phim, thấy hay mình khen dở mình chê nha) OK zô phim nào mí bạn \nĐầu tiên thấy tiếc cho Huỳnh Lập ghê trời, phim này mà ra hồi Tết là chắc thắng rồi...",
    "aspects": [
      {
        "aspect_name": "Kịch bản",
        "aspect_summary_review": "Kịch bản này rất hay, rất hấp dẫn, rất lôi cuốn, có nhiều tình tiết bất ngờ",
        "total_review": 100,
        "sentiments": [
          { "sentiment": "Tích cực", "total_review": 80 },
          { "sentiment": "Tiêu cực", "total_review": 20 },
          { "sentiment": "Trung tính", "total_review": 0 }
        ],
        "top_reviews": [
          {
            "review_id": "395534886433172",
            "review_desc": "phim Huỳnh Lập làm lúc nào cũng luôn chỉn chu từ những chi tiết nhỏ, diễn xuất tự nhiên và lôi cuốn",
            "sentiment": "Tích cực",
            "evidence": "phim Huỳnh Lập làm lúc nào cũng luôn chỉn chu từ những chi tiết nhỏ"
          },
          {
            "review_id": "395534886433173",
            "review_desc": "kịch bản quá cũ, diễn viên diễn không tự nhiên, âm nhạc ấn tượng, hình ảnh đẹp",
            "sentiment": "Tiêu cực",
            "evidence": "kịch bản quá cũ"
          }
        ]
      },
      {
        "aspect_name": "Diễn xuất",
        "aspect_summary_review": "Diễn xuất của các diễn viên rất tốt, rất tự nhiên, rất lôi cuốn",
        "total_review": 100,
        "sentiments": [
          { "sentiment": "Tích cực", "total_review": 80 },
          { "sentiment": "Tiêu cực", "total_review": 20 },
          { "sentiment": "Trung tính", "total_review": 0 }
        ],
        "top_reviews": [ "..." ]
      }
    ]
  }
}
Cấu trúc response này rất ổn khi giao tiếp với LLM — tự nhiên, phân tầng đúng theo cách con người tư duy, prompt cũng dễ viết. Nhưng đây là một cấu trúc rất khó xử lý với backend:
Khó lưu trữ. Cục JSON lồng 4–5 tầng, có thể dùng schema-less nguyên blob (mất khả năng query), hoặc phải define schema cứng cho từng tầng.
Khó cache. Cache theo
productIdthì mỗi lần đổi một review nhỏ phải invalidate cả json. Không cache được ở mức chi tiết hơn (ví dụ riêng một aspect).Khó mở rộng. Nếu trong tương lại prompt thêm tầng mới (ví dụ "sub-aspect", hay "review theo thời gian"), schema cứng lại phải migrate.
Còn với app, parse nested-JSON Object để render ra UI cũng là một bài toán hóc búa, ảnh hưởng đến performance, mỗi lần thay đổi cấu trúc là client phải sửa theo.
Vấn đề gốc: chúng ta đang cố ép một thứ vốn là cây phân cấp vào một document phẳng. Vậy thì sao không ứng xử với câu trúc này như 1 cây, và mô hình hoá dưới dạng đồ thị cho hoành tráng?
Mô hình hóa bài toán: từ nested-JSON Object thành đồ thị
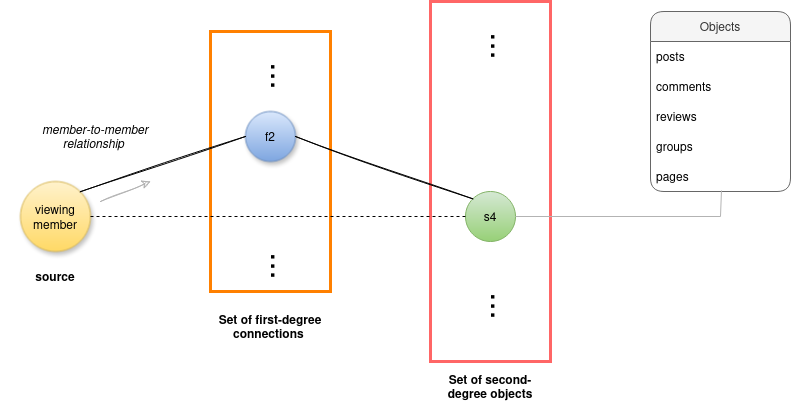
Nhìn lại cấu trúc kia, bỏ hết tên gọi đi, nó chỉ là một cái cây:
                    PRODUCT (Nhà Gia Tiên)
                   /                      \
          ASPECT (Kịch bản)          ASPECT (Diễn xuất)
                |                          |
            SENTIMENT                  SENTIMENT
           (Tích cực...)              (Tích cực...)
            /        \                  /        \
   TOP_REVIEW   TOP_REVIEW       TOP_REVIEW   TOP_REVIEW
Mỗi node là một "thứ gì đó" (product / aspect / sentiment / review), và giữa các node là quan hệ cha → con. Đây chính là đồ thị có hướng. Mà nói tới đồ thị thì hai anh bạn quen thuộc xuất hiện: BFS để duyệt theo tầng, DFS để dựng lại cấu trúc.
BFS là gì?
BFS (Breadth-First Search) duyệt đồ thị theo từng tầng: xử lý hết các node ở tầng hiện tại rồi mới đi xuống tầng kế tiếp, dùng Queue để giữ thứ tự. Ở bài toán này, điểm hay của BFS không nằm ở "duyệt cho đúng" mà nằm ở chuyện gom batch:
Tầng 0:  [product]                          -> 1 lần multiGet
Tầng 1:  [aspect_1, aspect_2]               -> 1 lần multiGet
Tầng 2:  [sentiment_1, sentiment_2, ...]    -> 1 lần multiGet
Tầng 3:  [review_1, review_2, ...]          -> 1 lần multiGet
Nếu fetch đơn giản kiểu "lấy node nào fetch node đó" thì số round-trip xuống DB/gRPC bằng đúng số node. Với BFS, mỗi tầng gom hết id rồi multiGet một lần, số round-trip chỉ bằng độ sâu của cây (ở đây là 4), không phụ thuộc số node — nên dùng BFS ở khâu kéo dữ liệu.
DFS là gì?
DFS (Depth-First Search) thì ngược lại: đi sâu hết một nhánh rồi mới quay lại nhánh khác, thường viết bằng đệ quy (dùng luôn call stack) hoặc một Stack tường minh.
Ở bài toán này hai thuật toán làm hai việc khác nhau, không thay thế nhau:
BFS dùng để kéo dữ liệu. Vì mục tiêu là gom batch theo tầng để giảm round-trip, BFS hợp một cách tự nhiên.
DFS dùng để dựng lại cây. Sau khi BFS đã nạp hết node vào memory (
dtoMap), việc lắp ráp lại cấu trúc cha → con vốn là thao tác đệ quy: dựng node hiện tại, rồi với mỗi reference lại dựng node con, rồi node con của con... Đúng tinh thần "đi sâu trước". Viết đệ quy ngắn và đọc dễ, và an toàn vì cây review chỉ sâu vài tầng nên không lo stack overflow.
BFS (theo tầng, gom batch):        DFS (đi sâu, dựng cây):

  product                            product
  ├─ aspect_1   aspect_2               └─ aspect_1
  ├─ sent...    sent...                     └─ sentiment
  └─ review...  review...                        └─ review_1
   (mỗi tầng = 1 multiGet)                       └─ review_2
                                          └─ aspect_2 ...
                                     (lắp ráp trong memory, 0 round-trip)
Nói gọn: BFS tối ưu khâu I/O, DFS tối ưu khâu lắp ráp.
Cách mô hình hóa
Mình tách bài toán thành ba phần rạch ròi: data structure, database, và cách ứng dụng (đọc/ghi).
1. Data structure — một cấu trúc node chung cho tất cả
Thay vì mỗi tầng một class riêng, mình dùng một kiểu DTO chung (CommonDto / GrpcExternalObjectDTO), phân biệt bằng field dtoType. Quan hệ cha–con nằm trong references — chính là danh sách kề (adjacency list) của một node đồ thị:
CommonDto {
  id            : long        // id nội bộ, sinh khi ingest
  dtoType       : string      // PRODUCT | ASPECT | SENTIMENT | SENTIMENT_TOP_REVIEW
  sourceId      : long        // id gốc từ hệ thống ngoài (product, review thật)
  name          : string
  value         : string      // nội dung tóm tắt / text review
  weight        : int         // total_review, dùng để thống kê
  references    : [ { name, refIds[] } ]   // cạnh trỏ xuống các node con
  timestamp     : long
}
Cái hay là mọi tầng đều cùng một kiểu. Thêm tầng mới (sub-aspect chẳng hạn) chỉ là thêm một giá trị dtoType, không đụng tới schema.
2. Database — một collection phẳng
Toàn bộ node nằm chung một collection external_object_dtos. Không lồng nhau, mỗi node một document. "Cây" được thể hiện qua references.refIds. Vì phẳng nên:
Cache được ở mức từng node (một aspect đổi thì chỉ invalidate node đó).
Một review có thể được nhiều sentiment tham chiếu mà không nhân bản dữ liệu.
Query, thống kê theo
dtoType/weightthoải mái.
3. Cách ứng dụng
Ghi (write path): parse cục JSON của LLM thành danh sách node phẳng, sinh id, và wire
referencescho parent trỏ xuống child.Đọc (read path): từ
productId(node gốc), BFS kéo toàn bộ node liên quan theo từng tầng, rồi DFS dựng lại thành cây cho client.
Lưu trữ: MongoDB Schema
Collection: external_object_dtos
{
  "_id": ObjectId,
  "dtoType": "string",         // PRODUCT | ASPECT | SENTIMENT | SENTIMENT_TOP_REVIEW
  "sourceId": "string",        // id gốc từ hệ thống ngoài
  "socialObjectType": "int",   // map sang enum GrpcFeedObjectType
  "name": "string",
  "value": "string",           // summary / sentiment / nội dung review
  "weight": "int",             // total_review
  "desc": "string",
  "references": [
    {
      "name": "string",        // "aspects" | "sentiments" | "sentiment_top_reviews"
      "refIds": ["ObjectId"]
    }
  ],
  "timestamp": "long"
}
Ví dụ vài node thật sau khi đã được "xé phẳng":
// PRODUCT (node gốc)
{
  "_id": ObjectId("product_1"),
  "dtoType": "PRODUCT",
  "sourceId": "562949953434832",
  "socialObjectType": 11,            // GFOT_FEED_PRODUCT
  "name": "Nhà Gia Tiên",
  "value": "Nhà Gia Tiên, một bộ phim thuộc thể loại hài, gia đình và tâm linh...",
  "references": [
    { "name": "aspects", "refIds": [ObjectId("aspect_1"), ObjectId("aspect_2")] }
  ],
  "timestamp": 1742414879174
}

// ASPECT
{
  "_id": ObjectId("aspect_1"),
  "dtoType": "ASPECT",
  "name": "Kịch bản",
  "value": "Kịch bản phim được đánh giá cao nhờ sự sáng tạo và ý nghĩa sâu sắc...",
  "weight": 1442,
  "references": [
    { "name": "sentiments", "refIds": [ObjectId("sentiment_1")] }
  ],
  "timestamp": 1742414879174
}

// SENTIMENT
{
  "_id": ObjectId("sentiment_1"),
  "dtoType": "SENTIMENT",
  "name": "Tiêu cực",
  "weight": 106,
  "references": [
    { "name": "sentiment_top_reviews", "refIds": [ObjectId("review_1"), ObjectId("review_2")] }
  ],
  "timestamp": 1742414879174
}

// SENTIMENT_TOP_REVIEW (lá)
{
  "_id": ObjectId("review_1"),
  "dtoType": "SENTIMENT_TOP_REVIEW",
  "sourceId": "395662792827797",
  "socialObjectType": 6,             // FEED_REVIEW_POST
  "value": "cũng có cảnh hù mà kịch bản không có gì đặc sắc",
  "timestamp": 1742414838064
}
Ghi dữ liệu: parse JSON của LLM thành các node phẳng
Lưu ý: muốn parent trỏ được xuống child thì id của child phải có trước. Nên thay vì duyệt top-down rồi ngồi quay lại fix reference, mình build bottom-up: dựng leaf (review) trước, lấy id của chúng, rồi mới dựng sentiment trỏ xuống; tương tự lên tới product.
public static List<CommonDto> parseJsonBody(String jsonBody) {
    List<CommonDto> all = new ArrayList<>();
    JSONObject body = new JSONObject(jsonBody).getJSONObject("body");
    long ts = body.optLong("timestamp", System.currentTimeMillis());

    List<Long> aspectIds = new ArrayList<>();
    JSONArray aspects = body.getJSONArray("aspects");
    for (int i = 0; i < aspects.length(); i++) {
        JSONObject aspect = aspects.getJSONObject(i);

        List<Long> sentimentIds = new ArrayList<>();
        JSONArray sentiments = aspect.getJSONArray("sentiments");
        for (int j = 0; j < sentiments.length(); j++) {
            JSONObject sentiment = sentiments.getJSONObject(j);

            // 1. Lá trước: top reviews
            List<Long> reviewIds = new ArrayList<>();
            JSONArray reviews = sentiment.optJSONArray("top_reviews");
            if (reviews != null) {
                for (int k = 0; k < reviews.length(); k++) {
                    JSONObject review = reviews.getJSONObject(k);
                    long reviewId = gen52BitId();
                    all.add(CommonDto.newBuilder()
                        .setId(reviewId)
                        .setDtoType("SENTIMENT_TOP_REVIEW")
                        .setSourceId(review.getLong("review_id"))
                        .setSocialObjectType(GrpcFeedObjectType.FEED_REVIEW_POST_VALUE)
                        .setValue(review.getString("review_desc"))
                        .setTimestamp(toTs(ts))
                        .build());
                    reviewIds.add(reviewId);
                }
            }

            // 2. Sentiment trỏ xuống các review vừa tạo
            long sentimentId = gen52BitId();
            all.add(CommonDto.newBuilder()
                .setId(sentimentId)
                .setDtoType("SENTIMENT")
                .setName(sentiment.getString("sentiment"))
                .setWeight(sentiment.getInt("total_review"))
                .addReferences(ref("sentiment_top_reviews", reviewIds))
                .setTimestamp(toTs(ts))
                .build());
            sentimentIds.add(sentimentId);
        }

        // 3. Aspect trỏ xuống các sentiment
        long aspectId = gen52BitId();
        all.add(CommonDto.newBuilder()
            .setId(aspectId)
            .setDtoType("ASPECT")
            .setName(aspect.getString("aspect_name"))
            .setValue(aspect.getString("aspect_summary_review"))
            .setWeight(aspect.getInt("total_review"))
            .addReferences(ref("sentiments", sentimentIds))
            .setTimestamp(toTs(ts))
            .build());
        aspectIds.add(aspectId);
    }

    // 4. Product là gốc, trỏ xuống các aspect
    all.add(CommonDto.newBuilder()
        .setId(gen52BitId())
        .setDtoType("PRODUCT")
        .setSourceId(Long.parseLong(body.getString("productId")))
        .setSocialObjectType(GrpcFeedObjectType.GFOT_FEED_PRODUCT_VALUE)
        .setValue(body.getString("summaryReview"))
        .addReferences(ref("aspects", aspectIds))
        .setTimestamp(toTs(ts))
        .build());

    return all;
}

// helper nhỏ cho gọn
private static GrpcExternalObjectDTO.Reference ref(String name, List<Long> ids) {
    return GrpcExternalObjectDTO.Reference.newBuilder()
        .setName(name)
        .addAllRefIds(ids)
        .build();
}
So với bản đầu chỉ add từng DTO vào một list phẳng mà không nối references, bản này mới thật sự dựng được đồ thị — và đó là tiền đề để read path BFS có cái mà duyệt.
Đọc dữ liệu: BFS để kéo dữ liệu, DFS để dựng lại cây
Read path gồm hai stage rõ ràng:
public class DtoGraphProcessor {
    private final GrpcExternalObjectServiceClient grpcClient;

    public DtoGraphProcessor(GrpcExternalObjectServiceClient grpcClient) {
        this.grpcClient = grpcClient;
    }

    public ResponseDto buildApiResponse(long productId) {
        // Stage 1: BFS kéo toàn bộ node liên quan, gom batch theo tầng
        Map<Long, CommonDto> dtoMap = fetchDtosWithBfs(productId);
        // Stage 2: DFS dựng lại thành cây cho client
        return buildResponse(dtoMap.get(productId), dtoMap);
    }

    private Map<Long, CommonDto> fetchDtosWithBfs(long rootId) {
        Map<Long, CommonDto> dtoMap = new HashMap<>();
        Queue<Long> queue = new LinkedList<>();
        queue.add(rootId);

        while (!queue.isEmpty()) {
            // gom hết id của tầng hiện tại -> multiGet 1 phát
            List<Long> batchIds = new ArrayList<>();
            while (!queue.isEmpty()) {
                batchIds.add(queue.poll());
            }

            List<CommonDto> fetched = grpcClient.multiGet(batchIds);

            for (CommonDto dto : fetched) {
                if (dtoMap.containsKey(dto.getId())) continue; // tránh duyệt lại
                dtoMap.put(dto.getId(), dto);
                for (CommonDto.Reference r : dto.getReferencesList()) {
                    queue.addAll(r.getRefIdsList());          // xuống tầng kế tiếp
                }
            }
        }
        return dtoMap;
    }

    // Stage 2: đệ quy (DFS) dựng cây từ dữ liệu đã nằm sẵn trong memory
    private ResponseDto buildResponse(CommonDto parent, Map<Long, CommonDto> dtoMap) {
        ResponseDto node = new ResponseDto(parent);
        for (CommonDto.Reference r : parent.getReferencesList()) {
            for (long refId : r.getRefIdsList()) {
                CommonDto child = dtoMap.get(refId);
                if (child != null) {
                    node.addChild(buildResponse(child, dtoMap));
                }
            }
        }
        return node;
    }
}
Điểm cần để ý: stage 1 đã kéo hết mọi node về dtoMap rồi, nên stage 2 dựng cây hoàn toàn trong memory, không còn gọi DB/gRPC lần nào nữa. Đệ quy ở đây an toàn vì cây review chỉ sâu vài tầng.
Kết quả
Và đây là thành phẩm chạy thật trên MoMo: link bài viết giới thiệu
Tóm lại, sau khi transform nested JSON object thành đồ thị node phẳng: round-trip cố định theo độ sâu cây (không theo số node), cache mịn tới từng node, thêm tầng mới không cần migrate schema, và kiến trúc reuse được cho các output nested về sau.
Nhìn lại, tiêu đề bài là nói cho vui. Bài học thì đơn giản: không nên phức tạp hoá khi không cần, nhưng khi dữ liệu vốn đã phức tạp thì mô hình hoá cho đúng từ đầu sẽ đỡ tốn công về sau. Vấn đề ở đây không phải là làm tính năng chi tiết, mà là ban đầu cố nhét một cấu trúc cây vào một cục blob — và phải trả giá ở khâu cache với mở rộng.
Fun fact: mình được A môn Toán rời rạc của thầy Nghĩa ở Bách Khoa. Đây vẫn là điều mình tự hào nhất trong 5 năm học đại học. Đúng là có học có hơn :)))))