Build Social Graph trên Oracle
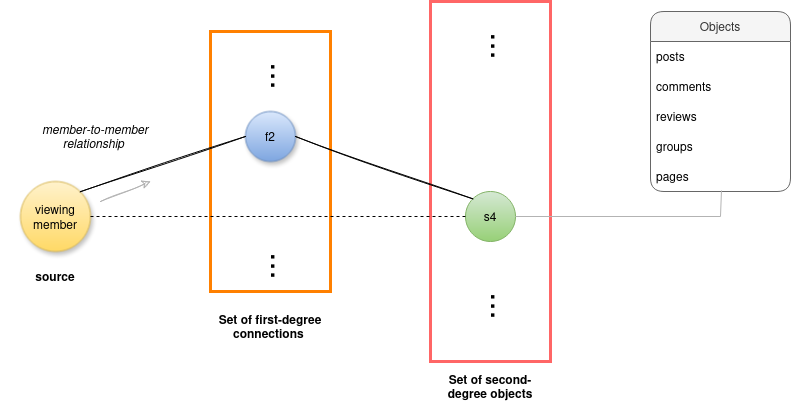
Xây dựng Social Graph bằng Oracle — Truy vấn comment của bạn bè theo post
Mô tả bài toán: "Với một danh sách bạn bè (tối đa cỡ hàng ngàn) và một danh sách các bài post, trả về theo từng post tối đa 5 comment mới nhất của bạn bè, sort theo
createdAtgiảm dần."
0. Data model
Quan hệ xã hội lưu dưới dạng edge trong một table SOCIAL_EDGES:
edge = (EDGE_ID, SRC_ID, SRC_TYPE, DEST_ID, DEST_TYPE, EDGE_TYPE, EDGE_TIME)
Một comment biểu diễn bằng hai edge:
edge 1:  user  --comment_authored-->  comment     (SRC=userId,    DEST=commentId)
edge 2:  comment --comment_on-->      post        (SRC=commentId,  DEST=postId)
Bài toán là một 2-hop query: friend → comment → post.
1. Tại sao lưu dạng graph 2 edge?
Một comment cần truy được ra commentId từ đó hydration để gắn vào post, và phải xoá được đúng từng cái. Một user có thể comment nhiều lần trên một post, và comment có thể bị xoá.
Giữ hai edge cho phép:
commentIdchính là intermediate node của path → luôn lấy được.Xoá một comment = xoá đúng hai edge của nó, không ảnh hưởng comment khác của cùng user trên cùng post.
Đổi lại, mọi query phải join hai edge. Phần còn lại của tài liệu xoay quanh việc giảm query cost của phép join này.
2. Tại sao dùng bind variable thay vì nối giá trị vào câu SQL?
Đây là quyết định quan trọng nhất về stability.
Khi danh sách friend/post được nối literal vào chuỗi SQL:
... WHERE SRC_ID IN (111, 222, 333) ... -- mỗi lần một giá trị khác
mỗi lần gọi sinh ra một SQL text khác nhau. Oracle hash text để tra shared pool; text khác nhau ⇒ cache miss ⇒ hard parse lặp lại. Hard parse cần library cache latch — một shared resource ở mức instance. Dưới traffic lớn, nhiều user load đồng thời tạo ra latch contention làm nghẽn cả database server.
Dùng placeholder, đẩy giá trị qua bind:
... WHERE SRC_ID IN (?, ?, ?) ... -- text cố định, giá trị đi riêng
SQL text giờ chỉ phụ thuộc số lượng phần tử, không phụ thuộc giá trị. Oracle parse một lần rồi reuse plan cho các lần gọi sau có cùng số lượng phần tử. Giá trị được bind vào ở bước execute qua params, không chạm vào template.
Giá trị bind phải đúng type của column. Column là DATE/NUMBER mà bind bằng String thì Oracle ngầm wrap column bằng implicit conversion, làm mất khả năng dùng index.
3. Index như thế nào?
CREATE INDEX ix_edges_dst ON SOCIAL_EDGES(DEST_ID, EDGE_TYPE, EDGE_TIME DESC);
CREATE INDEX ix_edges_src ON SOCIAL_EDGES(SRC_ID,  EDGE_TYPE, EDGE_TIME DESC);
Nguyên tắc B-tree: column có selectivity cao đứng trước, column range/sort đứng sau.
SRC_ID/DEST_IDlà id, selectivity rất cao — một id chỉ dính ít row.EDGE_TYPEchỉ có vài giá trị, mỗi giá trị phủ nhiều row nên selectivity thấp. Đặt id lên đầu để thu hẹp nhanh nhất.EDGE_TIME DESCđứng cuối vì nó phục vụ hai vai trò trên cùng một column: range predicateEDGE_TIME >= floorvàORDER BY EDGE_TIME DESC.
Để EDGE_TIME >= floor là access predicate (seek) chứ không phải filter, column phải đứng ngay sau các equality column.
4. Tại sao tạo index theo cả hai chiều (SRC và DEST)?
Một index chỉ seek nhanh theo leading column. Query có thể filter từ phía post (WHERE DEST_ID IN ...) hoặc phía friend (WHERE SRC_ID IN ...), tuỳ driving side. Index dẫn đầu bằng SRC_ID không phục vụ được query filter DEST_ID, và ngược lại. Cả hai chiều đều xuất hiện trong hệ nên duy trì cả hai index.
5. Tại sao filter theo thời gian (floor) lại là đòn bẩy chính?
floor là một time lower bound: EDGE_TIME >= :floor, suy từ chính các post đầu vào:
floor = MIN(createdAt của các post trong danh sách)
Bound này không làm rớt kết quả: một comment luôn được tạo sau khi post tồn tại, nên commentTime ≥ post.createdAt ≥ floor. Mọi comment cũ hơn floor chắc chắn không thuộc các post này. Đây là exact filter, không phải approximate.
Intermediate node (tập comment) là chỗ dễ phình. Một user hoạt động lâu năm có nhiều comment trong lịch sử; không có time bound thì phải đọc toàn bộ lịch sử rồi mới loại. Các bài post mới thường hiển thị nhiều hơn các post cũ, các post mới nên floor gần hiện tại, cắt bỏ phần lịch sử cũ, giữ intermediate result set nhỏ trước khi join.
Giữ floor kể cả khi tải nhẹ: nó giữ query cost ổn định khi lượng comment tăng.
6. Tại sao chọn driving side dựa trên đặc tính data?
Cost của 2-hop query tỉ lệ với kích thước intermediate result set, không phải kích thước final result. Nên drive từ phía tạo ra intermediate set nhỏ hơn.
Đặc tính data của hệ này:
Friend comment thưa — toàn bộ danh sách friend chỉ tạo vài trăm comment mỗi khoảng thời gian.
Post skewed — có post vài nghìn comment, có post một hai cái.
Suy ra:
Drive từ FRIEND:  intermediate set (comment của friend) nhỏ → filter post sau → nhẹ
                  viral post không ảnh hưởng vì không xuất phát từ post
Drive từ POST:    viral post vài nghìn comment → intermediate set to → phần lớn bị loại khi filter
                  friend → lãng phí
Drive từ phía friend là default cho hệ này: dùng index ix_edges_src + floor thu intermediate set xuống nhỏ, rồi join sang post. Đây là lựa chọn data-dependent — khi friend trở nên active mạnh (comment dày), sẽ phải đánh giá lại. Nếu optimizer chọn sai driving side, chúng ta có thể ép bằng LEADING hint và giữ stats cập nhật.
7. Tại sao join phù hợp với bài toán này?
Join là native operation của Oracle. Index đóng hai vai trò:
Trước join: index thu nhỏ input — seek friend/post + floor thay vì full scan table edge.
Trong join: index cho phép probe bằng seek thay vì scan.
Input đã nhỏ nhờ phần 5–6 nên bước join rẻ.
8. Tại sao top-5-per-post dùng ROW_NUMBER?
"Mỗi post tối đa 5 comment mới nhất" là bài top-N per group, biểu diễn bằng window function:
ROW_NUMBER() OVER (PARTITION BY <post> ORDER BY EDGE_TIME DESC) AS rn
...
WHERE rn <= 5
Cost của bước này do kích thước intermediate set sau join quyết định — set đó đã được floor và driving side kéo nhỏ ở các phần trước.
9. Tại sao gộp về một query thay vì fanout nhiều query song song?
Tách danh sách thành nhiều batch bắn song song nhân số concurrent connection và số lần parse lên, làm cạn connection pool dưới tải cao — dạng "chết vì nhiều round-trip".
Gộp toàn bộ danh sách vào một query, truyền qua bind (phần 2): một SQL, một connection, một lần parse. Nếu buộc phải batch vì giới hạn tầng dưới, dùng bounded concurrency thay vì fanout không kiểm soát.
10. Tóm tắt các quyết định
| Quyết định | Lý do cốt lõi |
|---|---|
| Lưu graph 2 edge | Giữ được commentId, xoá comment đúng từng cái |
| Bind thay vì literal | SQL text cố định → parse một lần → tránh hard parse storm gây latch contention |
Composite index: id trước, EDGE_TIME sau |
Seek theo id selectivity cao; EDGE_TIME phục vụ cả range floor lẫn ORDER BY |
| Index cả hai chiều (SRC & DEST) | Index chỉ seek theo leading column; cần cả hai để drive được từ mỗi phía |
EDGE_TIME >= floor |
Exact filter (không rớt kết quả), thu nhỏ intermediate node |
| Drive từ friend | Friend comment thưa → intermediate set nhỏ; tránh viral post |
| Gộp về một query | Một connection, một lần parse; tránh cạn connection pool |
ROW_NUMBER cho top-5/post |
Biểu diễn top-N per group bằng SQL |
Nguyên tắc xuyên suốt: cost quyết định bởi kích thước intermediate result set, không phải final result. Mọi quyết định — bind, index, floor, driving side — đều nhắm giữ intermediate set nhỏ.