Scalable Bloom Filter
Giới thiệu
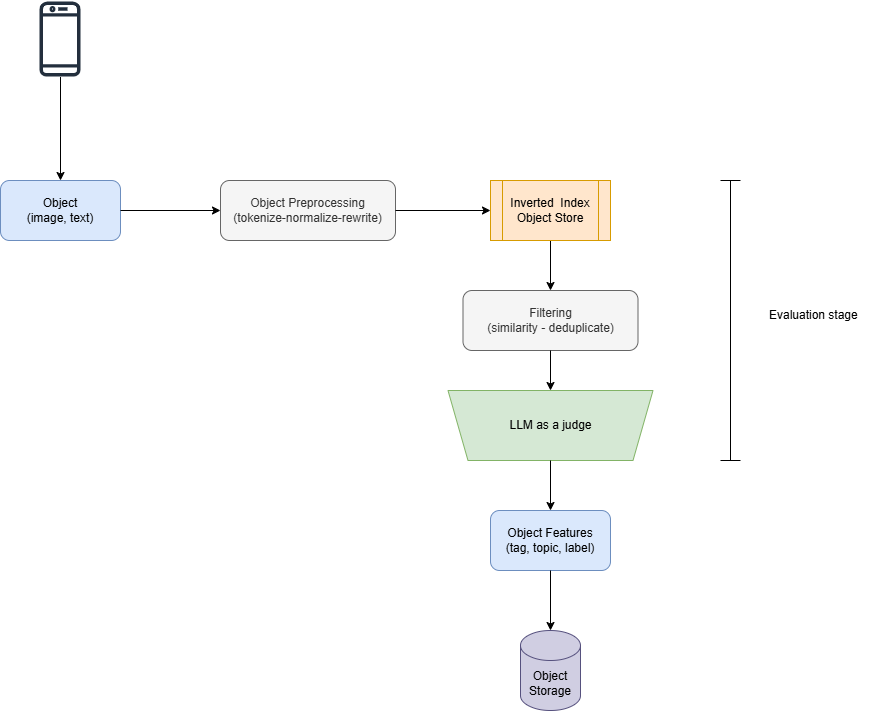
Để xây dựng hệ thống ranking nội dung cho hàng triệu user là một bài toán phức tạp và yêu cầu tối ưu cao về latency. Kết quả trả về không chỉ cần được cá nhân hóa mà còn cần trả về với độ trễ thấp. Ngoài việc áp dụng, cải thiện các model tính toán để đưa ra kết quả cá nhân hóa tốt nhất thì việc giảm process time từng stage trong ranking pipeline giúp trải nghiệm của user tốt nhất.
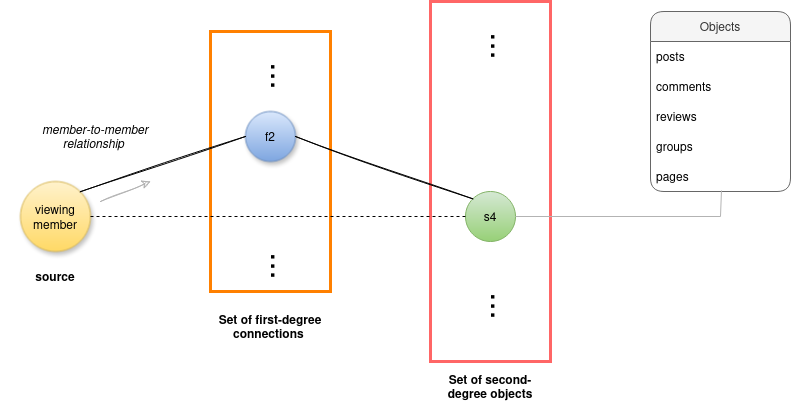
Ranking pipeline bắt đầu bằng việc chọn lọc các candidate, sau đó là bước tính toán score để sắp xếp candidate theo độ freshness, quality của bài viết, số lượng interaction và relevant, trong đó phần relevant score là phức tạp nhất. Phần điểm relevant score dựa trên social graph tôi có giới thiệu ở blog trước, bây giờ còn phần tính toán relevant score các thuộc tính của bài viết với các thuộc tính của user.
Cụ thể hơn, bài toán tính relevant score giữa các bài viết candidate có các thuộc tính gắn các object và các tương tác của user với các object, object có thể là 1 sku, 1 brand hay 1 voucher.
Có thể hình dung bài toán dưới dạng hai "column": một column có các row là các gắn với candidate post, một column gồm các row là object mà user từng tương tác. Việc tính relevant score quy về bài toán membership filtering.
        POST COLUMN                           USER COLUMN
   (object của candidate)              (object user từng tương tác)

  ┌───────────────────────┐          ┌───────────────────────┐
  │  Post A               │          │  User U               │
  │    ├─ sku:123         │          │    ├─ sku:123    ◄──┐  │
  │    ├─ brand:5         │          │    ├─ brand:9       │  │
  │    └─ voucher:7       │          │    ├─ sku:456       │  │
  ├───────────────────────┤          │    └─ voucher:7 ◄─┐ │  │
  │  Post B               │          └──────────────────┼─┼──┘
  │    ├─ sku:999         │                             │ │
  │    └─ brand:5         │                             │ │
  └───────────────────────┘                             │ │
              │                                          │ │
              │        có object nào trùng không?        │ │
              └──────────────────────────────────────────┘ │
                         sku:123, voucher:7  ────────────────┘
Bài toán được làm gọn lại: bài post có gắn object nào mà user từng tương tác không?
Đây là bài toán kiểm tra thành viên (membership test): với mỗi object của post, hỏi "object này có nằm trong tập object user đã tương tác không?". Tập object user tương tác có thể rất lớn và trải dài theo thời gian, nếu lưu nguyên tập rồi tra thì tốn bộ nhớ và không đạt yêu cầu latency. Đây là chỗ Bloom filter phát huy.
Bloom filter là gì?
Bloom filter là một cấu trúc dữ liệu xác suất (probabilistic) dùng để kiểm tra một phần tử chắc chắn chưa nằm trong tập hợp. Nó đánh đổi độ chính xác tuyệt đối để lấy bộ nhớ cực nhỏ và tốc độ tra cứu O(k).
Bản chất Bloom filter là một dãy bit (bitset) khởi tạo toàn 0, cùng với k hàm hash độc lập. Mỗi hàm hash map một phần tử vào một vị trí trong bitset.
Khi add một phần tử: chạy phần tử qua k hàm hash, được k vị trí, set tất cả các bit tại các vị trí đó lên 1.
Khi kiểm tra một phần tử: chạy qua k hàm hash, được k vị trí. Nếu tất cả các bit tại các vị trí đó đều bằng 1 → phần tử có thể đã có. Nếu có ít nhất một bit bằng 0 → phần tử chắc chắn chưa có.
Bitset ban đầu (m = 12 bit):
index:  0  1  2  3  4  5  6  7  8  9 10 11
        0  0  0  0  0  0  0  0  0  0  0  0

add("sku:123")  ->  h0=2, h1=5, h2=9
        0  0  1  0  0  1  0  0  0  1  0  0
              ▲        ▲        ▲

add("brand:5")  ->  h0=1, h1=5, h2=10
        0  1  1  0  0  1  0  0  0  1  1  0
           ▲     (bit 5 đã là 1, giữ nguyên)

check("sku:123") -> h0=2, h1=5, h2=9  -> bit[2],bit[5],bit[9] = 1,1,1 -> CÓ THỂ CÓ
check("sku:777") -> h0=3, h1=6, h2=9  -> bit[3]=0                     -> CHẮC CHẮN KHÔNG
Điểm mấu chốt: Bloom filter là false positive. Với bài toán của chúng ta, false positive nghĩa là một object thực ra user chưa tương tác lại bị coi là đã tương tác — chấp nhận được ở mức tỉ lệ nhỏ, vì nó chỉ làm relevant score nhiễu nhẹ chứ không làm mất dữ liệu.
Hàm hash
Bloom filter cần k hàm hash cho ra k vị trí indepent với nhau.
Cách tôi dùng: với mỗi vị trí i (từ 0 đến k-1), băm chuỗi ghép giữa phần tử gốc và chỉ số i:
private int[] getSetArray(Object obj) {
    int[] positions = new int[keySize];   // keySize = k
    for (int i = 0; i < keySize; i++) {
        positions[i] = Math.floorMod((obj + "#" + i).hashCode(), setSize);
    }
    return positions;
}
Điểm quan trọng là bản thân phần tử gốc có mặt ở mọi lần băm (obj + "#" + i), chứ không phải băm lại một giá trị hash trung gian. Nhờ đó k vị trí thực sự độc lập, entropy của phần tử được đưa vào từng vị trí, và tỉ lệ false positive bám sát công thức lý thuyết.
Vài chi tiết trong hàm:
"#" + iđảm bảoklần băm chokchuỗi khác nhau tuyệt đối, không lo hai vị trí trùng input.Math.floorMod(h, setSize)luôn cho kết quả trong[0, setSize). DùngfloorModthay vìMath.abs(h) % setSizeđể tránh trường hợphashCodetrả vềInteger.MIN_VALUE(khi đóMath.absvẫn ra số âm).
Cách tính độ sai lệch
Tỉ lệ false positive của một Bloom filter (với k hàm hash độc lập) xấp xỉ:
p ≈ (1 - e^(-k·n/m))^k
Trong đó:
m= số bit trong bitsetk= số hàm hashn= số phần tử đã add
Ví dụ:
m = 1,000,000   (NUM_OF_BITS_IN_FILTER)
k = 5           (NUM_OF_HASH_FUNCTION)
n = 100,000     (NUM_OF_ITEMS_IN_FILTER — số phần tử tối đa mỗi bitset)
Thay số:
k·n/m         = 5 × 100,000 / 1,000,000 = 0.5
1 - e^(-0.5)  = 1 - 0.6065 = 0.3935
p             = 0.3935^5 ≈ 0.0094 ≈ 0.94%
Nghĩa là khi một bitset chứa đủ 100,000 phần tử, tỉ lệ báo nhầm "đã có" vào khoảng ~0.94%. Tỉ số m/n = 10 bit mỗi phần tử là một cấu hình khá tiêu chuẩn; giá trị k tối ưu theo lý thuyết là k = (m/n)·ln2 ≈ 6.9, nên k = 5 thấp hơn một chút nhưng vẫn cho tỉ lệ chấp nhận được.
Vấn đề của Bloom filter
Bloom filter cơ bản không hỗ trợ xóa phần tử — việc này không ảnh hưởng đến bài toán này (tập tương tác của user chỉ tăng theo thời gian, không cần xóa). Nhưng một số vấn đề khác thì không đơn giản như vậy:
Độ sai lệch tăng theo số phần tử. Càng add nhiều phần tử vào cùng một bitset kích thước cố định, càng nhiều bit bị set lên 1, và tỉ lệ false positive tăng dần. Với
mcố định, khinvượt xa ngưỡng thiết kế thìptiến nhanh về 1.Không tự mở rộng. Kích thước bitset phải chọn trước dựa trên số phần tử ước lượng. Nếu ước lượng sai, hoặc không thể ước lượng, bitset hoặc quá nhỏ (false positive cao) hoặc quá lớn (lãng phí bộ nhớ).
Không đếm được số phần tử. Bản thân bitset không cho biết đã add bao nhiêu phần tử — không thể phân biệt một bit lên 1 là do một hay nhiều phần tử.
Cải tiến: kết hợp Bloom filter với HyperLogLog
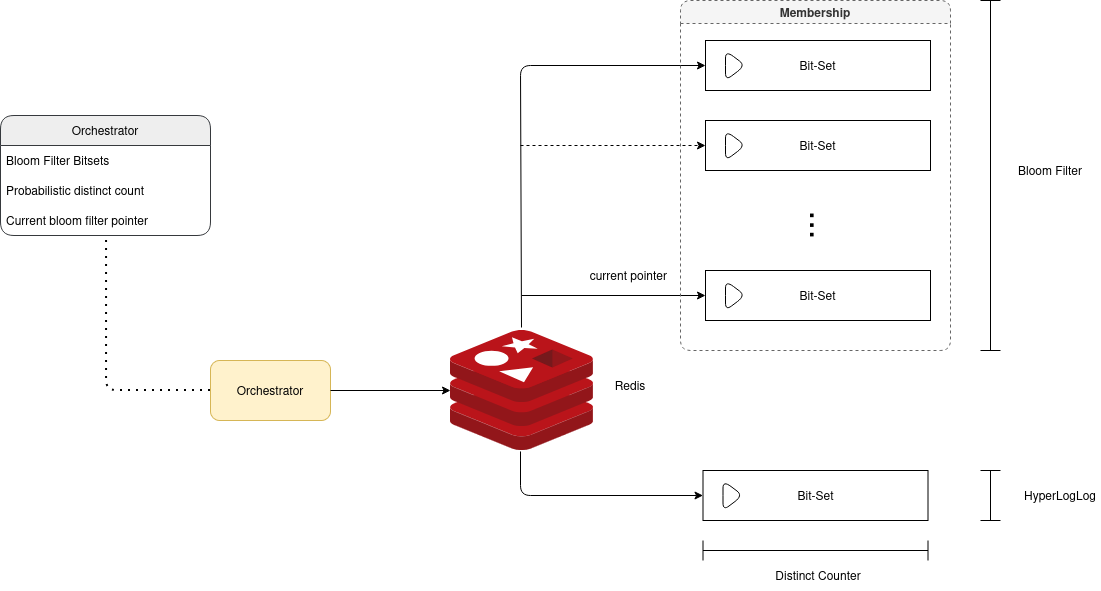
Để khắc phục ba vấn đề trên, tôi kết hợp Bloom filter với HyperLogLog và chia nhỏ bitset:
HyperLogLog đảm nhận việc ước lượng số phần tử phân biệt (cardinality) với bộ nhớ rất nhỏ, giải quyết vấn đề "không đếm được".
Bitset được tách thành một mảng các bitset (segment), mỗi segment chỉ chứa tối đa một số lượng phần tử cố định (ở đây là 100,000). Khi segment hiện tại đầy, tạo segment mới. Điều này giữ tỉ lệ false positive của từng segment ở mức thiết kế thay vì tăng vô hạn, đồng thời cho phép cấu trúc "tự mở rộng".
Luồng xử lý:
Ước lượng số phần tử hiện có bằng HyperLogLog, từ đó suy ra số segment cần thiết:
số_segment = cardinality / sức_chứa_mỗi_segment + 1.Khi kiểm tra (contains): với mỗi phần tử cần kiểm tra, băm ra
kvị trí, rồi duyệt qua tất cả các segment. Phần tử được coi là "đã có" nếu nó khớp (tất cả bit = 1) ở bất kỳ segment nào.Khi add phần tử mới: ghi phần tử vào segment cuối cùng (segment đang mở), đồng thời add vào HyperLogLog để cardinality được cập nhật. Khi cardinality cho thấy segment hiện tại đã đầy, lần add tiếp theo sẽ rơi vào một segment mới.
Vì mỗi phần tử chỉ được ghi vào một segment, và khi kiểm tra ta quét mọi segment, cấu trúc vẫn giữ được tính chất không có false negative của Bloom filter — miễn là số segment lúc đọc không nhỏ hơn lúc ghi. HyperLogLog có tính chất chỉ tăng (cardinality ước lượng không giảm theo thời gian), nên điều kiện này luôn thỏa.
Mảng bitset (mỗi segment ≤ 100,000 phần tử):

  segment 0 (ĐẦY)          segment 1 (ĐẦY)          segment 2 (đang ghi)
 ┌─────────────────┐      ┌─────────────────┐      ┌─────────────────┐
 │ 1 0 1 1 0 1 ... │      │ 0 1 1 0 1 0 ... │      │ 1 0 0 0 1 0 ... │
 └─────────────────┘      └─────────────────┘      └─────────────────┘
   100,000 phần tử          100,000 phần tử          < 100,000 phần tử
        │                        │                        ▲
        │                        │                        │  add phần tử mới
        └────────────────────────┴────────────────────────┘  vào đây

  contains(x): tra x qua CẢ 3 segment
               -> "đã có" nếu khớp ở BẤT KỲ segment nào

  Khi segment 2 đầy 100,000 phần tử -> tạo segment 3, ghi tiếp vào segment 3
Tradeoffs
Độ sai lệch sẽ tăng theo số lượng bitset trong mảng. Lý do là khi kiểm tra một phần tử, ta quét qua tất cả các segment và coi là exist nếu khớp ở bất kỳ segment nào, nên xác suất false positive ở từng segment cộng dồn lại. Ví dụ như sai số ở 1 bitset là 1% thì có 5 bitset thì sai lệch xấp xỉ 5% (chính xác hơn là 1 - (1 - 0.01)^5 ≈ 4.9%), nhưng nhỏ hơn nhiều so với việc add thêm phần tử vào bitset đã quá tải. Chẳng hạn nếu dồn 500,000 phần tử vào một bitset đơn kích thước 1,000,000 bit, tỉ lệ false positive sẽ vọt lên khoảng 65% — cao hơn cả chục lần so với cách chia segment.
Nói cách khác, cách chia segment đổi một chút sai lệch cộng dồn (tăng chậm, gần như tuyến tính theo số segment) để tránh sai lệch bùng nổ (tăng theo hàm mũ khi một bitset bị quá tải).
Cách kết hợp này cho ta một Bloom filter vừa ước lượng được số phần tử (nhờ HyperLogLog), vừa tự mở rộng khi dữ liệu tăng (nhờ chia segment), trong khi vẫn giữ bộ nhớ nhỏ và tốc độ tra cứu nhanh của Bloom filter gốc.